AIチャットボット・RAG開発|資料検索・問い合わせ対応を効率化したい方へ

同じ質問に、何度も答えなくてよくなる

社内資料、製品仕様、過去対応、議事録をまたいで探し、質問に答えるAIチャットボット・検索システムを作ります。答えには必ず、どの資料のどこを見たかが付きます。

AIの答えを信じるかどうかは、示された原文をその場で開いて自分で決められます。資料にないことには「分からない」と返し、見てよい権限のある人にだけ資料を出します。

相談では、対象の業務・成功条件・費用の考え方を整理します。NDA後の検証用デモは0円で、どこまで作るかは打ち合わせのうえ当社が判断します。その先は準委任(月額)で、PoCから本番運用まで(おおむね3〜4か月)を計画上の目安とし、費用は300万円〜(税別)です。対象業務や連携範囲に応じて、範囲が決まった時点で都度お見積もりします。期間は対象業務や連携範囲によって変わります。

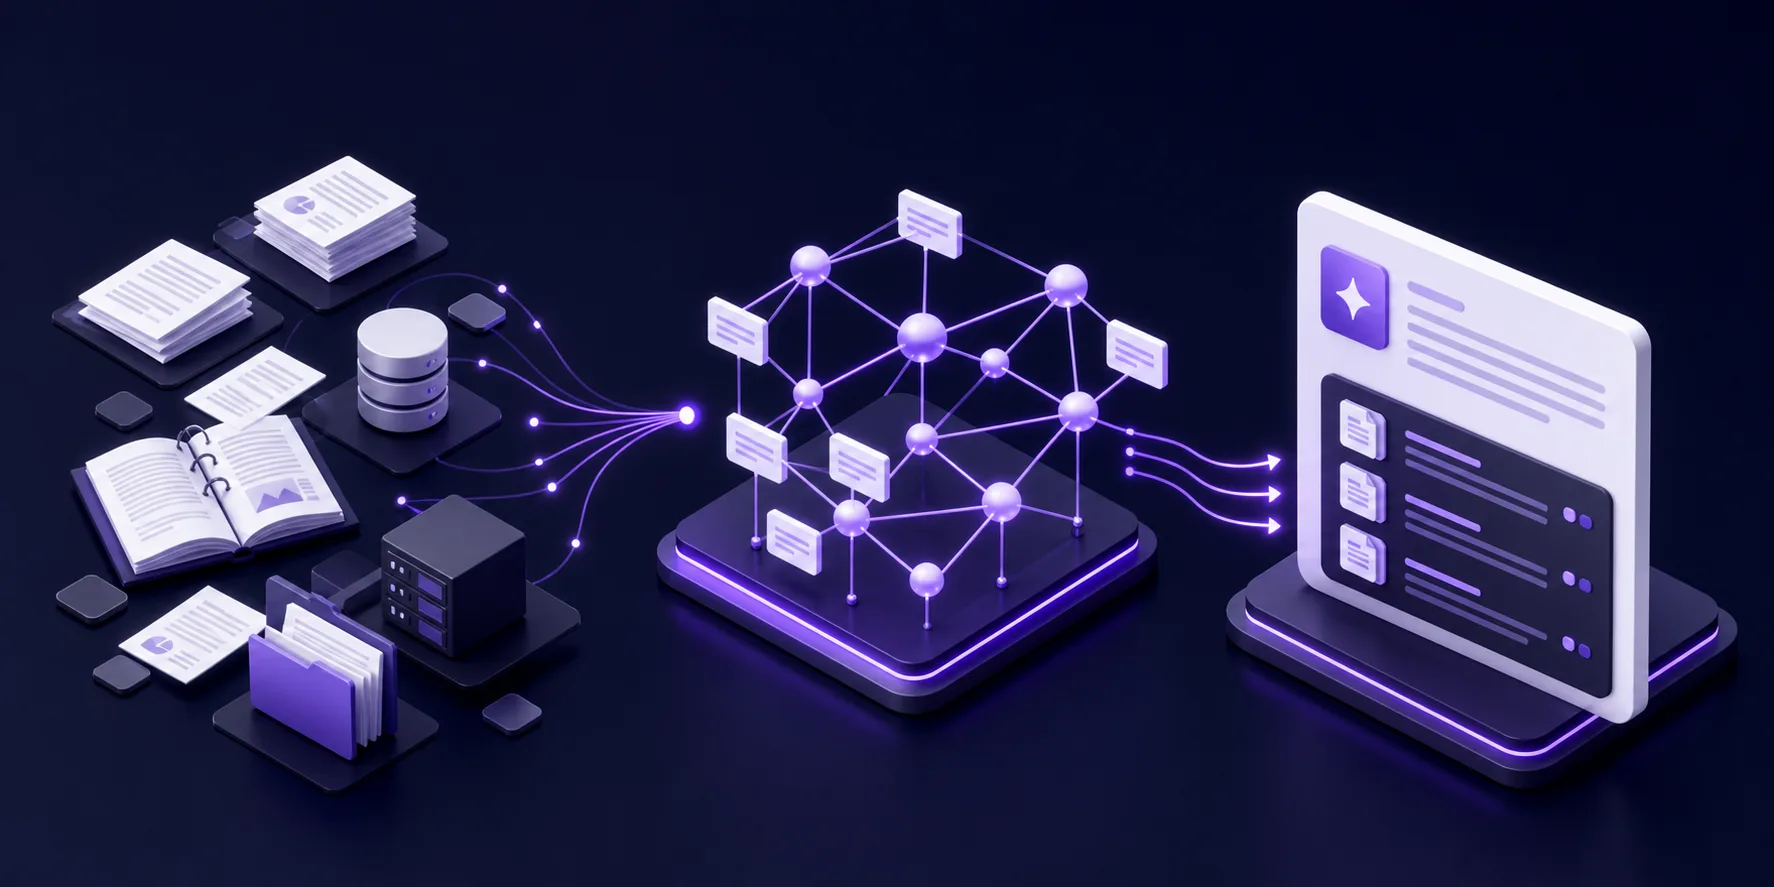
散らばった社内資料をつなぎ、根拠を示しながら回答するRAGシステムの流れ
初回相談と、実データで動かす1業務分のデモ
0円NDA締結後に作ります。どこまで作るかは打ち合わせのうえ当社が判断し、合わなければそこで終了です。
お問い合わせへの返信
1〜2営業日通常1〜2営業日以内に、想定構成・概算レンジ・進め方の候補を返信します。
PoCから本番運用まで(おおむね3〜4か月)
300万円〜開始価格の目安です(税別)。対象業務や連携範囲に応じて、範囲が決まった時点で都度お見積もりします。

データの扱いとセキュリティ

  • NDAを結んでから、合意した範囲のデータだけをお預かりします
  • 入力を学習に使わない契約のAPIか、Beekleのサーバーで動かすモデルを使います
  • 閲覧権限を検索結果とAIの回答に反映し、実行の履歴を残します
データの扱いとセキュリティを詳しく見る

社内の情報検索でよくある課題

資料を探すたびに、本来の仕事が止まっていませんか。

  • 同じ質問が、何度も自分のところに来る

    資料の場所を教えるために手を止めます。答え終わると、別の人から同じ質問が来ます。答えた内容は、その場限りで消えていきます。

  • 置き場所は決めたのに、どこに何があるか誰も分からない

    共有ドライブもSharePointもあります。それでも最新版がどれか分からないので、結局あなたに聞きに来ます。

  • 自分が休むと、その業務が止まる

    判断の理由は、自分の頭の中にだけあります。引き継ごうにも、どこから書けばいいか分かりません。

  • 必要なのは分かっているが、社内を通せない

    費用の根拠と、情シスに聞かれることへの答えが手元にありません。説明資料を自分で作る時間も、日々の業務に取られています。

AI検索が役立つ業務の例

  • 最新版がどれか分からない社内文書・規程を探す
  • 製造業で、型番・仕様・適合や後継品を確認する
  • 技術マニュアルから、機種と版に合う手順を引く
  • カスタマーサポートで、問い合わせ履歴とマニュアルを横断して答える
  • 営業で、過去の商談記録や失注理由をたどる
  • 既存のRAGが、複数の資料をまたぐ質問に答えられない

1つでも当てはまれば、相談していただけます。業務ごとの詳しいページは下に並べています。資料が整理されていなくても、いまの状態のままお預かりして、どこまで使えるかを先に確かめます。

放っておくと、人件費が余計にかかり続けます。そのうえ、古い版や別の条件の資料で判断すれば、後工程でのトラブルの元になります。答えられる人が辞めれば、その人の暗黙知による判断基準は失われます。

いま導入を検討する理由

資料が増えるほど、詳しい人に質問が集中します。

資料は毎日増えます。増えるほど探す時間は長くなり、全体を把握している人に質問が集まります。全社に生成AIを配っても、自社の資料を根拠に答えられなければ、この状態は続きます。

資料が整理されるのを待たずに始められます

資料もデータも、待つほど散らかったまま増えていきます。増えた分だけ、分かる人の頭の中に残る量も増えます。資料が散らかったままでも、着手できます。いまの状態のままお預かりして、どこまで使えるかを先に確かめます。

以前は費用や精度で見送った業務も、再検証できます

精度や費用が合わずに見送った業務なら、前提が変わっています。いまの最上位クラスのAIは、提供が終わった前世代と比べて料金が3分の1です。一度に渡せる資料の量は5倍になり、長い資料を入れても、単価は同じです(Anthropicの公開価格、2026年9月時点)。見送りの判断は、当時の料金と当時の上限で出したものです。測り直さない限り、古いまま残ります。

発注を決める前に、無料デモで確かめられます

初回の相談と、実データでの叩き台までは0円です。要件書や予算が無い段階から、相談できます。合わなければその時点で終了できるので、確かめるところまでは期初や稟議を待たずに始められます。

他社が公表しているAI活用事例

製造、建設、カスタマーサポート。どれも各社が公表している取り組みで、対象は「資料を探す」「複数の資料を突き合わせる」という、どの会社にもある仕事です。

  • 製造業の設計・開発

    パナソニック コネクト

    図面と設計仕様の照合を、AIに任せた

    図面・設計仕様の照合業務で、人が目視で行っていた作業時間を最大97%削減したと公表しています。確認漏れによる後工程の手戻りを減らすことも狙いに挙げています。

    出典:パナソニック(2026年2月)
  • 建設業

    大成建設

    社内の技術資料を、生成AIから引ける検索にした

    経験の浅い社員でも専門分野の技術情報にたどり着けるようにした仕組みです。専門家が用意した模範解答と突き合わせて、もっともらしい誤答を止めています。

    出典:大成建設(2024年10月)
  • カスタマーサポート

    LinkedIn

    過去の問い合わせ対応の履歴を、検索できる形に作り直した

    LinkedInのカスタマーサポートチームで約6か月運用し、問い合わせ1件あたりの解決時間(中央値)が28.6%短くなったと報告しています。

    出典:arXiv:2404.17723

いずれも各社が公表している数値で、Beekleの実績ではありません。データも体制も会社ごとに違うので、自社で同じことが起きるかは、0円のデモで実際に測ります。

担当者が変わっても、業務の知識を引き継げるように

1回探すのにかかる時間 × 1日に起きる回数 × 関わる人数。これが、1日あたりの検索に使う時間です。時間あたりの人件費と年間の稼働日数を掛ければ、年間費用の目安が出ます。

同じくらい効いているのが、答えられる人が限られていることです。型番と適合表と過去の対応を突き合わせないと出ない質問に答えられるのは、いまも特定の人だけです。その人が辞めれば、判断の理由ごと無くなります。

ナレッジシステムで答えと根拠を共有できれば、詳しい人に毎回聞かずに確認できるようになります。費用の目安は300万円〜(税別)です。導入前後で実際に減った作業時間を測り、運用費も含めた費用と比較して、投資回収の見込みを確認します。

探していた人
資料を開いて回る代わりに、答えとその根拠がどの資料のどこにあるかが返ります。原文を1つ確かめて、判断に進めます
聞かれていた人
同じ質問が自分のところへ集まらなくなります。手を止めて資料の場所を教える時間が、自分の仕事に戻ります
入ったばかりの人
誰に聞けばいいか分からなくても、過去の対応と根拠にたどり着けます。詳しい人を捕まえるまで待たずに済みます

AI検索の導入で変わる業務

資料探しから回答・文書作成まで、社内の情報を活用できます。

社内資料、製品仕様、過去対応、議事録を根拠に、質問に答え、問い合わせに返し、文書の下書きまで出します。どれも、どの資料のどこを見たかが一緒に返ります。

  1. 今の状態

    資料を探し、詳しい人に確認する

    心当たりのあるフォルダを順に開き、関係しそうな記述を拾い、最後は詳しい人に確認する。答えを出すことより、判断材料をそろえることに時間がかかっています。業務は属人化しています。

  2. AI検索の導入

    回答と一緒に、根拠となる資料の箇所が分かる

    質問の種類ごとに検索を分け、回答と一緒に「どの資料のどこを見たか」を出します。資料にない質問は「分からない」と返します。ハルシネーションを抑制します。

  3. 導入後

    根拠となる原文を確認して、判断する

    返ってきた該当箇所だけ開いて確かめ、そのまま回答・申請・作業へ進みます。人に聞くのは、資料に書かれていないことだけになります。

探す時間が短くなるだけでなく、これまで特定の人しか答えられなかった質問にも、根拠つきで答えが出ます。

いま

導入後

情シス・総務・人事|社内から聞かれたことに答える

資料の置き場所を探して、口頭やチャットで返す。答えた内容は残らない。

聞いた本人が答えを受け取る。どの資料のどこが根拠かも一緒に出る。

カスタマーサポート|顧客からの問い合わせに返す

過去の対応履歴を1件ずつ開いて、似た事例を探す。

似た事例と、そのときどう答えたかが根拠つきで出る。

営業・管理|定型の文書を書く

前回の資料を探して開き、コピーして書き直す。

社内資料を根拠に下書きが出る。中身は示された原文で確かめる。

技術・開発|過去に似た案件がなかったか調べる

思い当たる人に聞いて回る。心当たりがなければ、ゼロから考え直す。

似た事例と、そのとき何をしたかが出る。同じ検討を二度しなくて済む。

現場全体|引き継ぎと教育

ベテランの時間を取って、口頭で教わる。

過去の判断とその理由を、新しい人が自分でたどれる。

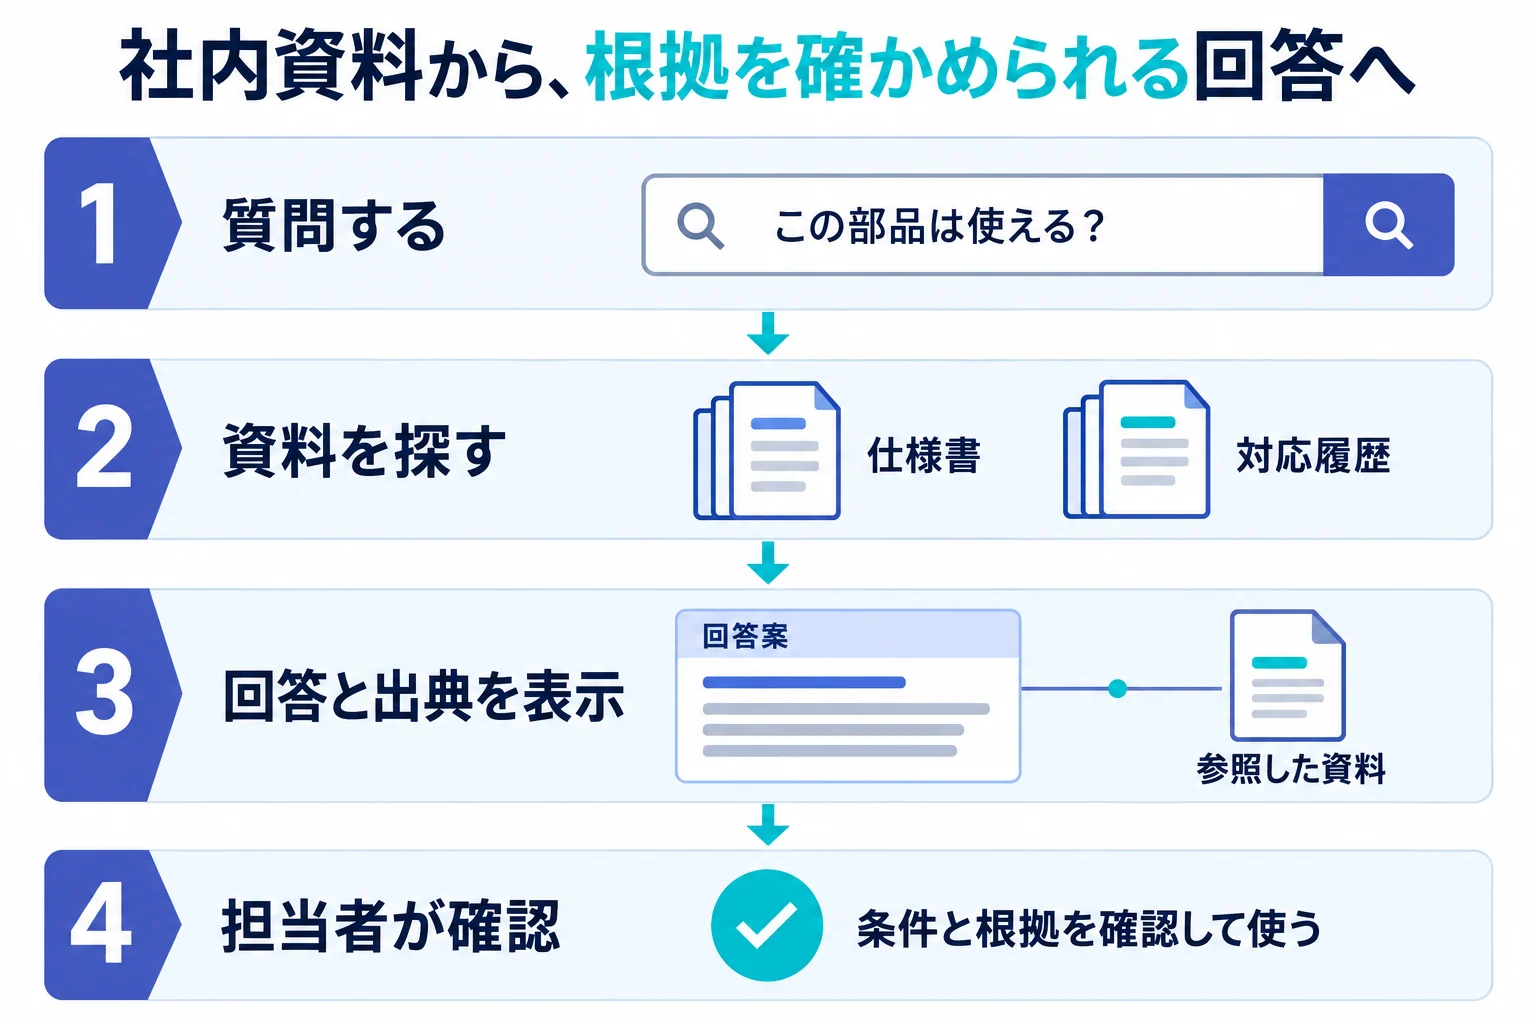
質問から関連する資料を探し、根拠を添えて回答を返すまでの流れを表した図
言い回しが違っても質問の意味で探し、どの資料のどこが根拠かを示します。

自社のデータで、デモを試しませんか。

NDA締結後に実データで検索を作り、答えの質を一緒に確認します。

NDA・デモから相談する

要件書は不要です。合わなければデモの段階で終了でき、費用は発生しません。

業務に合うAI検索の作り方

現場で聞かれる質問から、検索の仕組みを設計します。

先に、答えるべき質問と、その根拠になる資料を決めます。順番が逆だと、精度が出ないときに何が原因か切り分けられず、PoCのまま止まります。どの質問にどの検索を使い、どこで「分からない」と返すかまで決めてから作ります。

  1. 01

    答えるべき質問を決める

    「何に答えられれば価値が出るか」を先に決めます。資料を全部入れる前に、現場で実際に出ている質問を集め、種類ごとに分けるところから始めます。

  2. 02

    資料から必要な情報を取り出せるか確認する

    型番や部品、日付や版、どれとどれがつながるか。こうした情報の取り出しは、人の手ではなく、たいていAIにやらせます。ただ、どれくらい手間がかかるかは資料の性質で変わります。書き方が揃っていれば速く済みますし、表記がばらけていたり紙をスキャンしただけのものが多ければ、そこに時間がかかります。検索の精度は、必要な情報さえ取り出せていれば出ます。だから最初に見るのは検索ではなく、御社の資料のほうです。

  3. 03

    回答に使う資料と、版・部署・製品の情報を整理する

    文書だけでなく、メタデータ、部署、図、照合ルールを洗い出し、どの資料を正本として扱うかを決めます。正本は、社内で正しいとみなす情報の元です。ここが決まっていないと、古い版の資料がそのまま回答に出ます。

  4. 04

    質問ごとに探し方を変え、根拠を返す

    質問を先に見分けて、探し方を変えます。言い方が違っても意味で拾う質問、条件で絞る質問、数を数える質問、複数の資料を突き合わせる質問、図を見る質問。回答には、どの資料のどこを見たかを添えます。資料に無いことは知ったかぶりをさせず、「分からない」と返します。

  5. 05

    回答精度を測り、導入後も改善する

    構成は実測で決めます。正解質問で測り、精度を下げる部品は外します。本番に出したあとも、答えられなかった質問、的外れな検索、古い情報を記録し、次のデータ整備と検索の改善に使います。

業務で使うための6つの確認項目

回答の精度と根拠を確かめ、閲覧権限や資料の更新にも対応します。

  1. 01

    実際の質問で精度を測る

    現場の質問セットで、正答・誤答・答えられなかったものを数えます。自社の業務システムでは、測定日・使ったモデル・コードの版まで残して評価しています。精度が落ちた部品は、実装済みでも外しました。

  2. 02

    回答の根拠を示す

    現場が答えを使えるのは、どの資料のどこを見て答えたかが出るときです。カスタマーサポートのナレッジ検索では、引用元を示しながら答える構成で作りました。

  3. 03

    質問の種類で探し方を変える

    「意味の近い文章を探す」やり方だけで組むと、「該当は何件あるか」「そもそも無いのか」を確かめる質問が外れます。数を数える質問、条件で絞る質問、複数の資料を突き合わせないと答えが出ない質問を最初に見分けて、それぞれ別の処理に回します。数や有無はAIに推測させず、データベースに数えさせます。

  4. 04

    閲覧権限を守り、最新の資料を使う

    本番に出す条件は、見せてはいけない資料と古い版を区別できることです。正本を決めて派生側を追随させる仕組みと、利用者ごとに見える資料を分ける制御まで作って運用しています。

  5. 05

    根拠が足りないときは、回答を控える

    根拠が足りないときは断定せず、資料からは確認できないと返します。回答を出したあとに根拠と突き合わせて直す処理まで実装しました。

  6. 06

    導入後も回答精度を確認する

    答えられなかった質問と的外れな検索を記録し、次のデータ整備と検索の改善に戻します。自社の開発現場では、この形で毎日動かしています。

開発実績

RAGで、社内資料や会話履歴を検索できるようにしました。

カスタマーサポートのAIナレッジ検索

何に困っていたか
問い合わせ履歴やマニュアルが大量にあるのに、キーワード検索では言い回しの違いを取りこぼし、複数文書にまたがる手順や例外対応を追うところで止まっていました。
何をしたか
メタデータ・全文・ベクトル・グラフ近傍・対応根拠の複数経路を統合し、引用元を示しながら自然文の質問に答えるHybrid GraphRAGを構築しました。
どうなったか
  • 言い回しが違っても答えに届く
  • 複数文書をまたぐ手順を追える
  • 資料にある根拠を確認して回答できる

実際のデータ量では、通常のベクトル検索だけだと精度も速度も足りなくなります。それが分かっていたので、最初から複数の資料を照合できる構成にしました。フロントからAI基盤、インフラまで自社で運用しています。

Beekle社内で、要件を決めた経緯を調べる検索

何に困っていたか
要件定義書や議事録、設計判断の記録が散在し、この要件を決めた経緯は何かという問いに、キーワード検索では届きませんでした。
何をしたか
要求・受入条件など役割ごとの正本を分け、タスク・テスト・設計判断へ本文を複製せず接続しました。Milvusで意味の近い情報を探し、Neo4jで要件・決定・ストーリーの経緯を突き合わせてたどれる仕組みです。
どうなったか
  • 決めた経緯にすぐ戻れる
  • 過去の判断の見落としを防ぐ
  • 変更の影響範囲がすぐ分かる

自社の要件管理システムで実際に使っている構成です。変更を正本へ戻し、派生した検索・グラフを追随させることで、コピーごとの内容ずれを防ぐ運用まで確かめたうえで持ち込めます。

過去の会話を参照して解説する翻訳AI

何に困っていたか
言語が違うユーザー同士が音声メッセージや通話でやり取りするアプリで、翻訳を返すだけでは前に何を話したかが残らず、会話がその場で途切れていました。
何をしたか
過去の会話と音声の文字起こしを検索できる形で保存し、AIが以前のやり取りを参照して解説や語彙の補足を返すRAGを組み込みました。FlutterとCloudflare Workersの上で、翻訳・通話・AI解説・語彙帳と同じ基盤で動いています。
どうなったか
  • 前の会話を踏まえた解説が返る
  • 分からない表現を語彙として残せる
  • 音声・通話のやり取りも同じ記憶で扱える

検索対象が文書ではなく会話ログでも、「何を検索できれば価値が出るか」から設計する進め方は同じです。モバイル画面、リアルタイム通話、エッジAPI、データ保存まで同じチームで実装しています。

商品の推薦理由を説明できるAI検索

何に困っていたか
生成AIに推薦文を書かせることも、候補をまとめて渡して並べさせることもできない商材で、出来合いのAIレコメンドはそのままでは使えない状態でした。そのうえで利用者は、探しているものを商品名で書けるとは限らず、なぜこの順番で薦めたのかを運営側が説明できる必要もありました。
何をしたか
検索と並べ替えを自前のAIレコメンドアルゴリズムで実装しました。BM25とベクトル検索を並走させてRRFで統合し、並べ替えは条件一致・嗜好適合・評点・予算適合の重み付き和で機械的に決めています。生成AIに任せたのは、自然文を条件に直す入口と、理由を文章にする出口だけです。
どうなったか
  • 言い回しが違っても意図した商品に届く
  • なぜこの並びかをスコアの内訳で説明できる
  • 1週間で動くPoCとして確かめられる

Beekleは、LLMに何をさせないかを先に決めてから設計します。並べ替えをLLMに渡さないことで、説明責任と応答速度と費用を同時に確保しました。精度は評価ハーネスの数値で見る形にしてあるので、辞書や重みを触った影響を回帰込みで確認しながら改善できます。

すべての開発事例を見る

業種・業務別の活用例

業務ごとの質問例と、活用方法を紹介します。

このページは判断基準・実績・費用の全体です。データの種類、質問の例、成果の見え方は、業務ごとのページに書いています。

Beekleに依頼する理由

複数の資料を照合する検索を、実装から運用改善まで任せられます。

複数の資料を照合しないと答えられない質問に対応する

一般的なAI検索は、正しい1つの文書に速くたどり着くことを目指します。ただ、あなたのところに聞きに来るのは、仕様書と適合表と過去の対応履歴を並べて確かめないと結論が出ない質問のほうです。私たちも最初の案件で、通常のベクトル検索だけでは資料をまたぐ質問に届かないことを実データで確かめました。だから資料を突き合わせる検索を前提に組み直しています。いちばん時間を取られている質問から、先に手を離せます。

製品・部署・版を絞り、質問に合う資料で回答する

全社の資料をひとまとめに検索すると、他部署の運用や古い版が混ざります。混ざれば結局、出てきた答えを人が確かめ直すことになり、聞かれる回数もそのまま残ります。部署・製品・契約種別・日付で絞り込める構造にしておくと、返ってきた答えをそのまま使えます。確かめ直す時間が消えます。

回答精度の変化を数字で確認できる

入れたAIが使われなくなる原因は、精度が落ちたことに誰も気づけないからです。正解例・NG例・判断が割れる質問を業務担当者と用意し、正答・誤答・答えられなかったものを数えます。良くなったのか悪くなったのかを勘で決めずに済みます。実際、評価で精度が下がった部品は、実装済みでも外しました。上に「効果は出ているのか」と聞かれたときに、あなたが数字で答えられる状態になります。

実装済みの機能と、設計判断の記録

  • 質問意図と条件の解析、グラフ検索、全文検索、ベクトル検索、図の検索、検索結果の統合、根拠の取得、回答後の検証まで含むRAGを実装しています
  • 件数の集計や「該当なし」の確認は類似検索に頼らず、専用の経路に分けています
  • LLMによる再ランキングは、評価で精度が下がったため通常経路から外しました。この判断も記録に残しています
  • 回答に根拠のない主張や引用元の取り違えがないかを検証する処理を持っています

必要な答えと根拠を先に決めて、そこから検索方法を組み立てます。構成は、流行の型より御社の質問に合わせて選びます。

3つの主力サービスに共通する作り方

曖昧な業務を、実装できる条件へ変える

誰が、どの場面で、何を見て判断しているかが決まらないまま作り始めると、動くものはできても、現場で使われないまま残ります。ヒアリングでいまの業務の流れ(As-Is)を書き出し、あるべき流れ(To-Be)との差分からアクターとユースケースを定義してから作ります。要求を洗い出して「作る・後回し・作らない」に絞り、作るものだけをユーザーストーリーと受入条件に落とします。AIを使う業務では、判断の条件と例外もこの段階で書き出します。ここを曖昧にしたまま作ると、動いても使われないものになります。

開発の速さと、丁寧なお客さま対応を両立する

自社開発の「PM on Rails」とAIエージェントで、情報整理や作業の引き継ぎを効率化しています。その分、担当者はお客さまとの対話、必要な機能の検討、難しい問題の解決に時間を使います。打ち合わせで決めたことを、開発と確認までつなぐ仕組みです。

AIだけでなく、その前後の仕事まで作る

利用者が触る画面、参照するデータ、処理の状態、外部システムとの連携、必要なら実機まで含めて、AIの機能を一つの業務として実装します。フロントからAI基盤、インフラまで同じチームで持つため、不具合が出たときに責任の切り分けから始めなくてすみます。

AIに答えさせない範囲を、先に決める

AIが判断する部分、システムが確定的に処理する部分、人が確認する部分を、最初に分けます。資料から確認できないことは、それらしい答えを作らずに「分かりません」と返します。答えるときは、どの資料のどこを見たかを添えます。資料は、見てよい権限のある人にだけ出します。ルールが決まりきった処理にはAIを使わず、プログラムで確実に処理します。何を読み、何を判断し、誰が承認し、何を実行したかは記録に残るので、あとから説明できます。

合わなければ、そこでやめられる

要件を言葉だけで固めず、ヒアリングの直後に動くプロトタイプを作って画面で確かめます。お客様のヒアリング議事録から提案依頼書を生成し、そのまま1日で動作するデモまで進めて「イメージとずれていない」と評価された案件があります。初回相談と、NDAを結んで実データで1業務分を動かすデモまでは無料です。本番に向けた品質・精度の検証や連携の作り込みからは、範囲と費用をご提示したうえで進めます。進むか見送るかは、動くものを見てから決められます。作らないほうがよいと判断したら、そう伝えます。有料に進んだあとの金額も、職種別の単価を公開しているので、体制と期間から自分で検算できます。AIの構成も同じ考え方で、高度な手法を先に足さず、実際の質問と実データで評価し、精度が下がるなら外します。何をまだ確かめられていないかも、そのつど書いて渡します。

導入の進め方・費用・適用条件

開発を進めるかは、自社のデータで試して決められます。

お金を払う前に、実物で確かめられる進め方です。「相談する」「デモで適合を確かめる」「有料の開発に進む」は、それぞれ別の判断として区切ってあります。

RAGの導入が向いている業務

  • 社内資料・仕様・過去対応が複数の場所に散らばり、探す時間と聞かれる人の負担が増えている
  • 規程、技術情報、契約、監査のように、回答の参照元を確認してから判断したい業務
  • 同じ製品・設備・規程を、複数の資料が別々の言い方で参照している
  • 精度を実際の質問で評価しながら、PoCで止めずに本番へ進めたい

別の手段や、事前の整理が必要な場合

  • 資料が少なく、全文検索やフォルダ整理で大半の質問に答えられる
  • 質問が1つの資料で完結し、全文検索やフォルダの整理で足りる
  • 正本を決める人と、更新を維持する運用者がいない
  • 資料にないことは「分からない」と返す設計なので、「AIが常に正しく答えること」が導入条件の業務
  1. STEP 01

    秘密保持契約とデータの共有

    秘密保持契約を結び、実際の業務データをお預かりします。

    情報の扱いを合意

  2. STEP 02

    解決したい課題と評価基準の整理

    減らしたい作業・費用と、何をもって成功とするかを整理します。

    業務成果を要件にする

  3. STEP 03

    無料デモで業務に合うか確認

    実データで動かし、業務に使える見込みを双方で確認します。

    合わなければ、ここで終了

  4. STEP 04

    社内での検討・発注の判断

    デモ、狙う効果、範囲と体制をもとに社内で検討いただきます。

    実現の見込みがあれば次へ

  5. STEP 05

    PoC・開発・運用

    PoCで先に確かめるのは、御社の資料からどこまで情報を取り出せるかです。ここは資料の性質で手間が変わります。見通しが立ったら、連携・権限・運用まで実装します。

    現場で使える仕組みへ

ゼロスタートの検証用叩き台

0円

NDAを結び、実際の業務データをお預かりして確認したうえで、1業務の代表データで動く叩き台を作ります。開発を進める価値があるかを双方で判断できるところまでが範囲です。合わなければ、双方ここで終了します。

PoC

準委任(月額)

叩き台で実現の見込みを確認できた場合だけ進み、実データで業務として成立するかを確かめます。範囲は、叩き台で分かったデータの状態と難しさをもとに決めます。単価は時間あたりで公開していて、金額は範囲が決まった時点で都度お見積もりします。

MVP・本番開発・運用

準委任(月額)

PoCの結果を見て、画面、連携、権限、運用まで同じ体制で続けます。範囲を狭める、方式を変える、見送る判断も各段階でできます。PoCから本番運用まで(おおむね3〜4か月)を計画上の目安とし、費用は300万円〜(税別)です。対象業務や連携範囲に応じて、範囲が決まった時点で都度お見積もりします。期間は対象業務や連携範囲によって変わります。

金額は案件ごとに変わります。デモで分かったデータの状態と難しさをもとに、都度お見積もりします。金額を左右するのは、対象文書の種類と量、正本と権限の整理状況、質問の種類の幅、連携先の数です。

時間単価(税別)

有償フェーズは準委任(月額)で、実際に動いた時間に単価を掛けて請求します。案件ごとに必要な職種と人数が変わるので、金額は範囲が決まった時点で都度お見積もりします。クラウド・API利用料は実費で別途かかります。

  • デザイナー:1時間あたり4,000〜5,500円
  • エンジニア:1時間あたり5,000〜8,000円
  • PM:1時間あたり10,000円
  • AIエンジニア:1時間あたり8,000円〜

相談の前に

よくある質問

RAG・GraphRAGの構築費用はどのくらいかかりますか?

ゼロスタートの叩き台は0円です。NDAを結んで実データを確認し、1業務分の代表資料で、根拠を示しながら答える検索が動くところまで無料で作ります。合わなければ、そこで費用なしに終了できます。そこから先は準委任(月額)で、単価は時間あたりで公開しています。デザイナーは1時間あたり4,000〜5,500円、エンジニアは1時間あたり5,000〜8,000円、PMは1時間あたり10,000円、AIエンジニアは1時間あたり8,000円〜。いずれも税別です。PoCから本番運用まで(おおむね3〜4か月)を計画上の目安とし、費用は300万円〜(税別)です。対象業務や連携範囲に応じて、範囲が決まった時点で都度お見積もりします。期間は対象業務や連携範囲によって変わります。クラウドやAPIの利用料は別途です。

こちら側で、何を準備する必要がありますか?

検索対象にしたい資料と、答えさせたい質問の例を3〜5個いただければ始められます。資料は整理前のままで大丈夫です。正本がどれか、最新版がどれかが決まっていない状態も、そのままお預かりして、こちらで確認しながら決めます。要件書は不要です。社内で用意していただくのは、資料を読み取るための権限と、業務を説明していただく時間です。

Google DriveやBoxに置いてある資料でも対象にできますか?

置き場所がGoogle Drive、Box、SharePoint、共有フォルダ、業務システムのどれでも、APIやエクスポートでファイルを取り出せれば検索対象にできます。実際に取り出せるか、どの形式が読めるかは、0円のデモの段階で現物を見て確認します。取り出しにくい置き場所があった場合も、そこで分かります。

社外秘のデータはどう扱いますか?

NDAを結んでからお預かりします。回答に使うモデルは、入力を学習に使わない契約のAPIか、こちらで用意したサーバー上で動かすモデルから選べます。Beekleは自社の検索システムを自前のサーバーで運用しているので、外部のSaaSに資料を預けない構成も作れます。閲覧権限は検索結果にも反映し、権限のない人の質問には該当資料が出ない状態にします。

どのくらいの文書量から意味がありますか?

量ではなく、質問の種類で決まります。1つの資料を開けば答えが出る質問しかないなら、量が多くても全文検索とフォルダの整理で足ります。逆に資料が少なくても、複数の資料を突き合わせないと答えが出ない質問や、特定の人しか答えられない質問が毎日出ているなら、意味があります。どちらかはデモの段階で判断できます。

PoCで何を確認できたら、本番へ進めますか?

4つです。実際の業務の質問で、正答・誤答・答えられなかったものを数えられること。回答と一緒に根拠の箇所が出ること。閲覧権限と文書の版を分けて扱えること。資料が更新されたときに追随できること。この4つが確認できた時点で、本番の範囲と費用を決めます。確認できなければ、範囲を狭めるか、見送る判断をします。

費用は何で増減しますか?

対象にする文書の種類と量、正本と権限がどこまで整理されているか、答えさせたい質問の種類の幅、つなぐ既存システムの数の4つです。有償フェーズは準委任なので、実際に動いた時間に単価を掛けて請求します。範囲を狭めれば費用は下がり、扱う資料の種類と連携先が増えるほど上がります。デモで分かったデータの状態をもとに、都度お見積もりします。

既にPoCを社内で試しましたが精度が出ません。改善できますか?

改善できます。まず、正本・版・権限、文書の区切り方、検索モデル、メタデータ、類似資料によるノイズのどこで失敗しているかを切り分けます。区切り方や検索モデルの調整で届く質問は、それで直します。複数の資料を突き合わせる質問が落ちていると実測できたところに、グラフや照合の経路を足します。どこを直すかは、切り分けた結果で決めます。

うちは通常のRAGとGraphRAGのどちらになりますか?

どちらにするかは、答えさせたい質問を見てこちらで決めます。通常のRAGは、社内文書から質問に近い部分を探してAIへ渡す作りで、1つのマニュアルやFAQに答えが書かれている質問ならこれで届きます。GraphRAGは、「この製品に合う部品と、その適用条件と、廃番時の後継品」のように、複数の資料を開いて突き合わせないと答えが出ない質問に向いています。こうした質問への回答精度を通常のRAGで確保できない場合に、GraphRAGを検討します。どちらにしても、同じ業務の質問で測ってから確定します。

データの更新頻度が高い場合でも対応できますか?

対応できますが、先に正本と許容する更新遅延を決めます。文書管理や業務システムを正本にし、ベクトルDBとグラフDBは派生データとして、CDC・Webhook・定期バッチなど適した方法で追随させます。追加・更新・削除だけでなく、版の競合、未反映、孤立したノード、古い関係を監視し、正本との差分でドリフトを検知します。変更内容によっては差分更新では足りず、再インデックスやグラフの再生成が必要です。

AIチャットボットやAIエージェントとの違いは何ですか?

チャットボットは利用者が質問する窓口で、RAGは必要な資料を検索して回答の根拠に使う仕組みです。Beekleでは両方を一つのサービスとして開発し、社内文書検索、部品・仕様の確認、社内外の問い合わせ対応など、用途に合わせて設計します。回答後の入力・更新・送信まで進めたい場合は、AIエージェントも組み合わせます。

RAGの仕組みと導入の判断材料

AIに相談する

普段のAIに、合うか聞いてみてください

社内の事情を知っているAIに「なぜ合うのか、なぜ合わないのか」を聞くと、問い合わせ前に判断材料が揃います。確認用の質問はこちらで用意しています。

目的別のサービス

情報検索から問い合わせ対応、業務の自動化まで相談できます。

資料検索・問い合わせ対応、営業データの活用、業務の自動化。自社で取り組みたい用途から、開発内容と費用を確認できます。

自社の資料で、必要な答えが出るか試しませんか。

扱いたい文書と、答えさせたい質問を伺い、どの探し方を組み合わせるかをこちらでご提案します。

送っていただきたいもの

  • 検索対象にしたい文書の種類と件数
  • 答えさせたい質問の例を3〜5個
  • 社外に出せないデータがあるか

送信後の流れ

  1. 通常1〜2営業日以内にご連絡し、オンラインで業務を伺います
  2. NDAを締結し、実データを確認します
  3. 0円の検証用デモをご覧いただき、進めるかを双方で判断します