1
今の状態
資料が散らばる
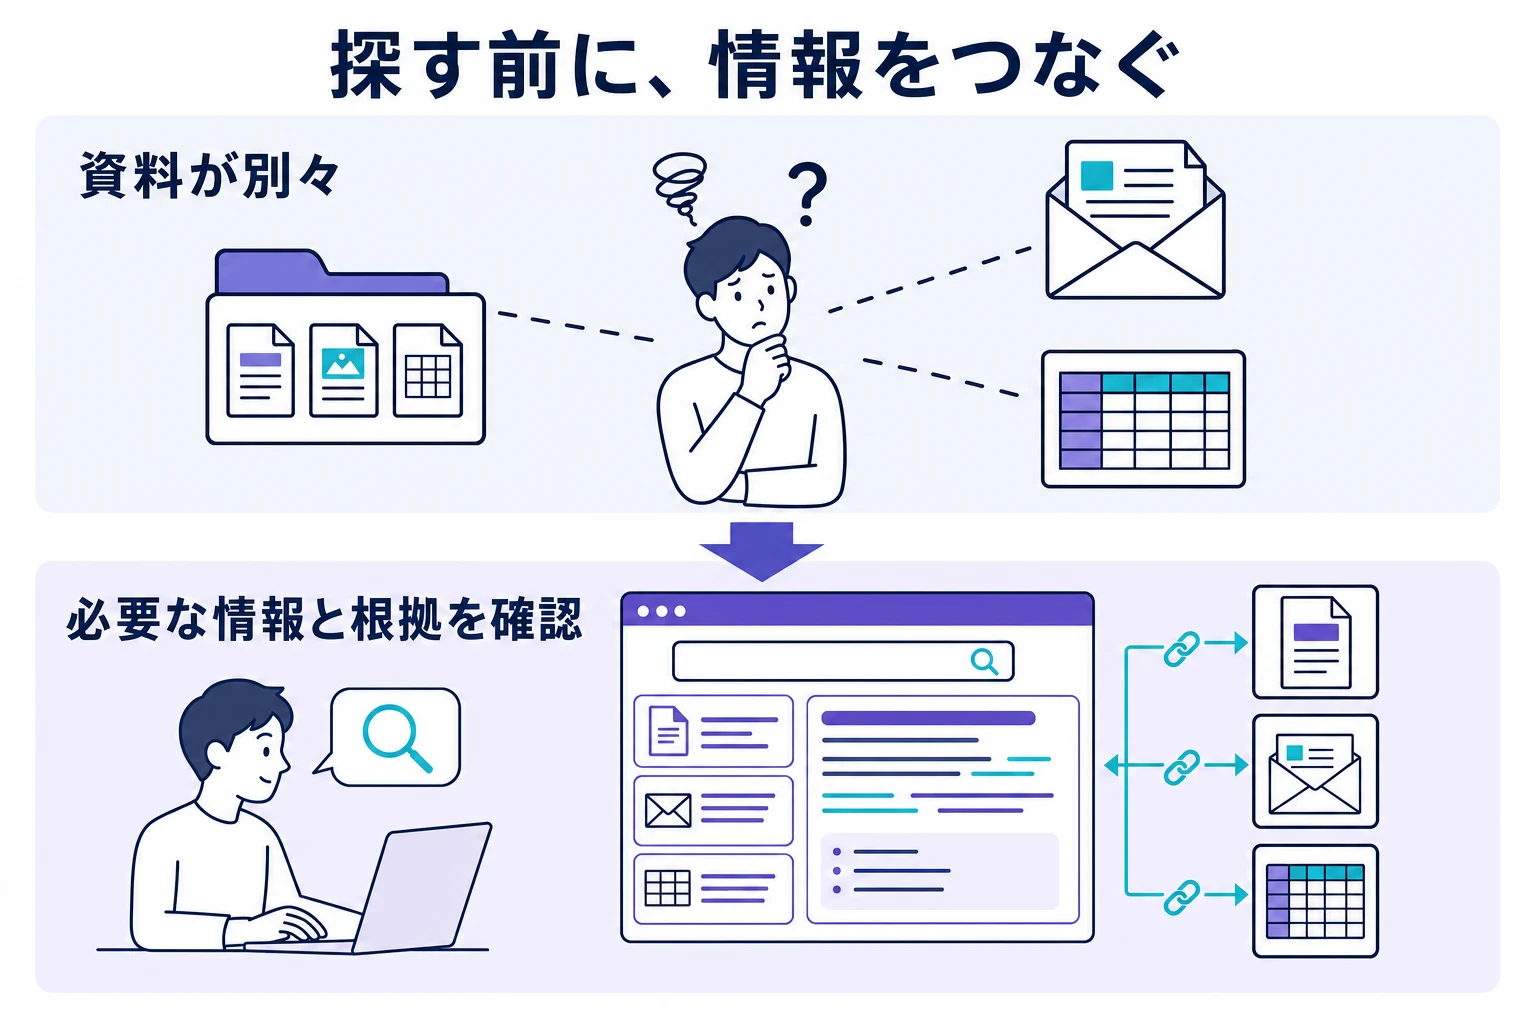
PDF、規程集、マニュアルが別々の場所にあり、探す人の経験に依存します。
PDF、マニュアル、規程集をただ検索対象に入れるだけでは不十分です。どんな質問に、どの根拠で答え、どこから人が確認するかを整理してから実装します。
文書検索AIの精度は、文書を入れる前のヒアリング、質問設計、根拠提示ルールで決まります。
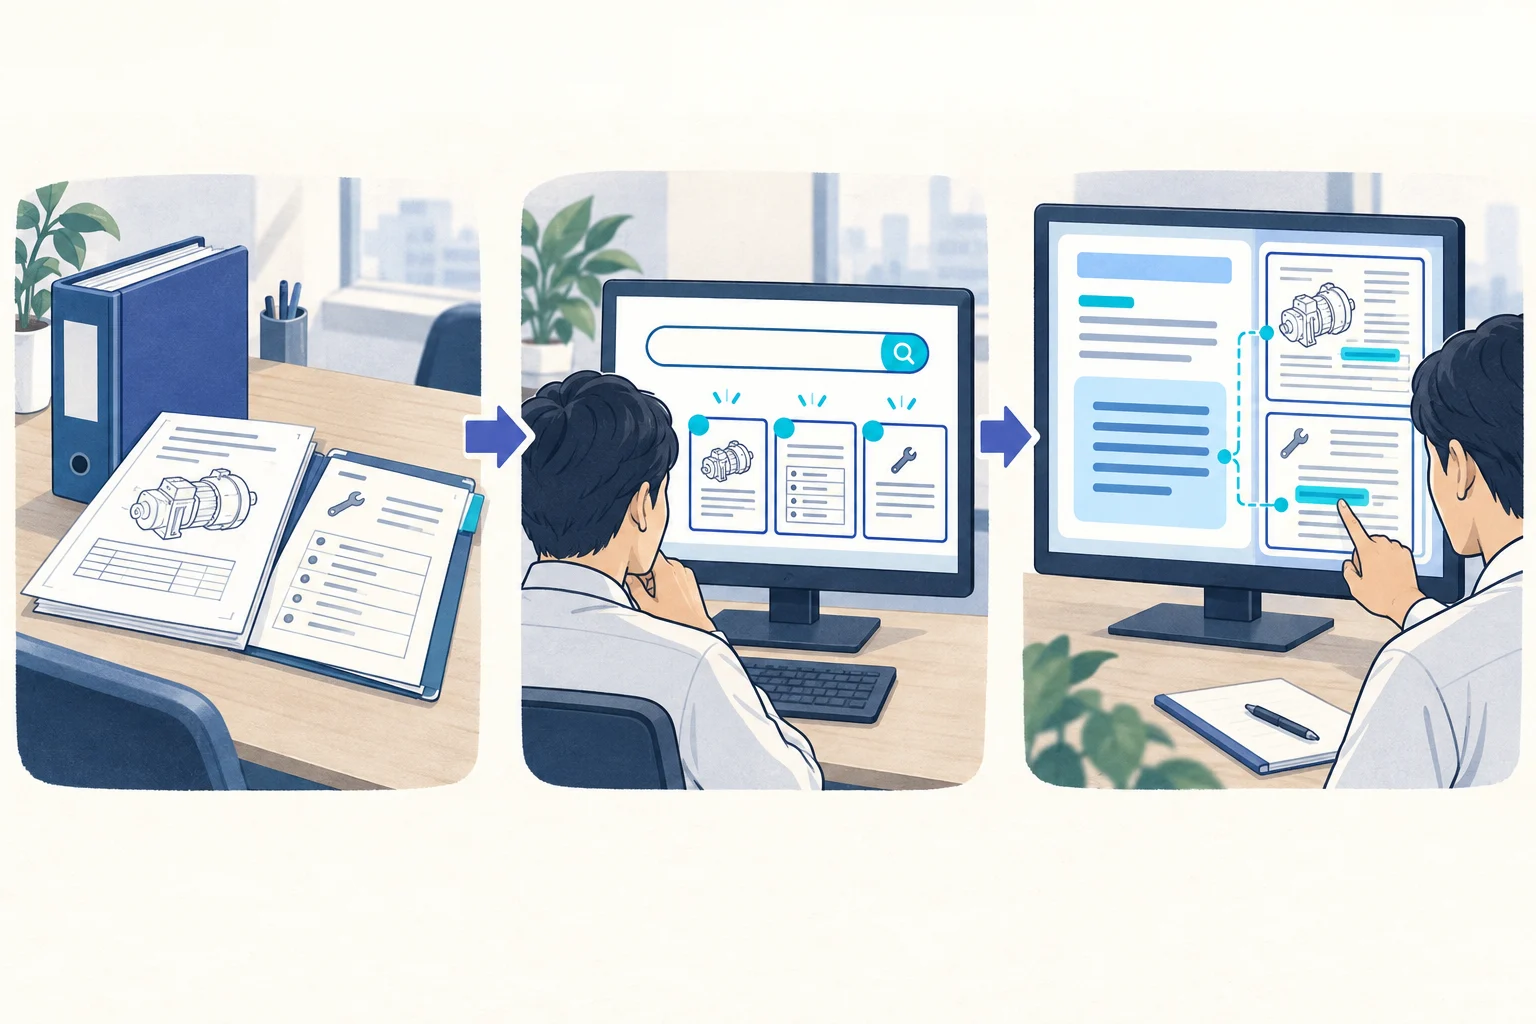
いまの業務で困っていることを確認します
部署ごとに保存場所が異なり、同じ社内規程でも最新版がどこにあるかわからない。検索しても目的の文書にたどり着けず、結局「知っている人に聞く」運用になっている。
ファイルサーバーやSharePointの検索機能ではキーワード完全一致しか対応できず、「出張時の経費精算の上限」のような自然文の質問には答えられない。PDF内のテキストが検索対象外のケースも多い。
規程やマニュアルが大量にあるが、どれを読めばよいかの案内がない。先輩社員への質問が集中し、教える側の業務時間も圧迫されている。
法改正や社内規程の改訂があるたびに最新版を探す手間が発生。古い版を参照してしまうリスクもあり、監査対応時に「根拠が示せない」ケースが生じている。
なぜ、探せないのか
「あるはずの答え」に届かないのは、AIの性能だけでなく、探し方、文書の置き方、根拠の出し方を先に決めていないことに原因があります。
全文検索はキーワードが一致しないと拾えず、表現の揺れや言い換えを取りこぼします。だから「あるはずの答え」に到達できません。
ファイルサーバー、SharePoint、個人フォルダに分かれ、横断して意味で探す仕組みが無いため、探せるかどうかが人の経験に依存します。
どの文書のどこが根拠かを示せないため、コンプライアンス確認やオンボーディングで結局原本を開いて読み直すことになります。
BEFORE / AFTER
ファイルを開いて読み比べる作業を減らし、必要な答えと確認元にすぐ到達できる状態を作ります。
今の状態
PDF、規程集、マニュアルが別々の場所にあり、探す人の経験に依存します。
Beekleの設計
表現が違っても関係する箇所を探し、回答と一緒に根拠文書を提示します。
導入後
担当者への確認や資料の読み比べを減らし、本来業務に時間を戻します。
新人教育、社内問い合わせ、規程確認など、繰り返し発生する確認業務を軽くできます。
SERVICE PACKAGE
「支援します」だけでは、何を買うのか分かりません。このサービスでどこまで進め、何が手元に残るかを先に共有します。
社内文書をただAIへ入れるのではなく、実際の質問に根拠付きで答えられ、権限を守って運用できる状態まで作ります。
SCOPE / 前提・境界
文書自体が古い、矛盾している、正本が決まっていない場合は、AIだけで解決できません。文書管理を先に直すべき範囲も含めて切り分けます。
RAG / ONTOLOGY DESIGN
ベクトル検索だけに頼らず、質問・用語・文書の関係と評価基準から設計します。
聞く
背景・業務・例外を聞き出す
絞る
効果が出る範囲に絞る
描く
構造・権限・評価基準を決める
同じ文書群でも、何を聞かれるかによって必要な分割単位もメタデータも変わります。先に実際の業務質問を集めてから設計するので、入れてみたが目的の答えに届かない、という作り直しが起きません。
AI UNCERTAINTY / RISK MANAGEMENT
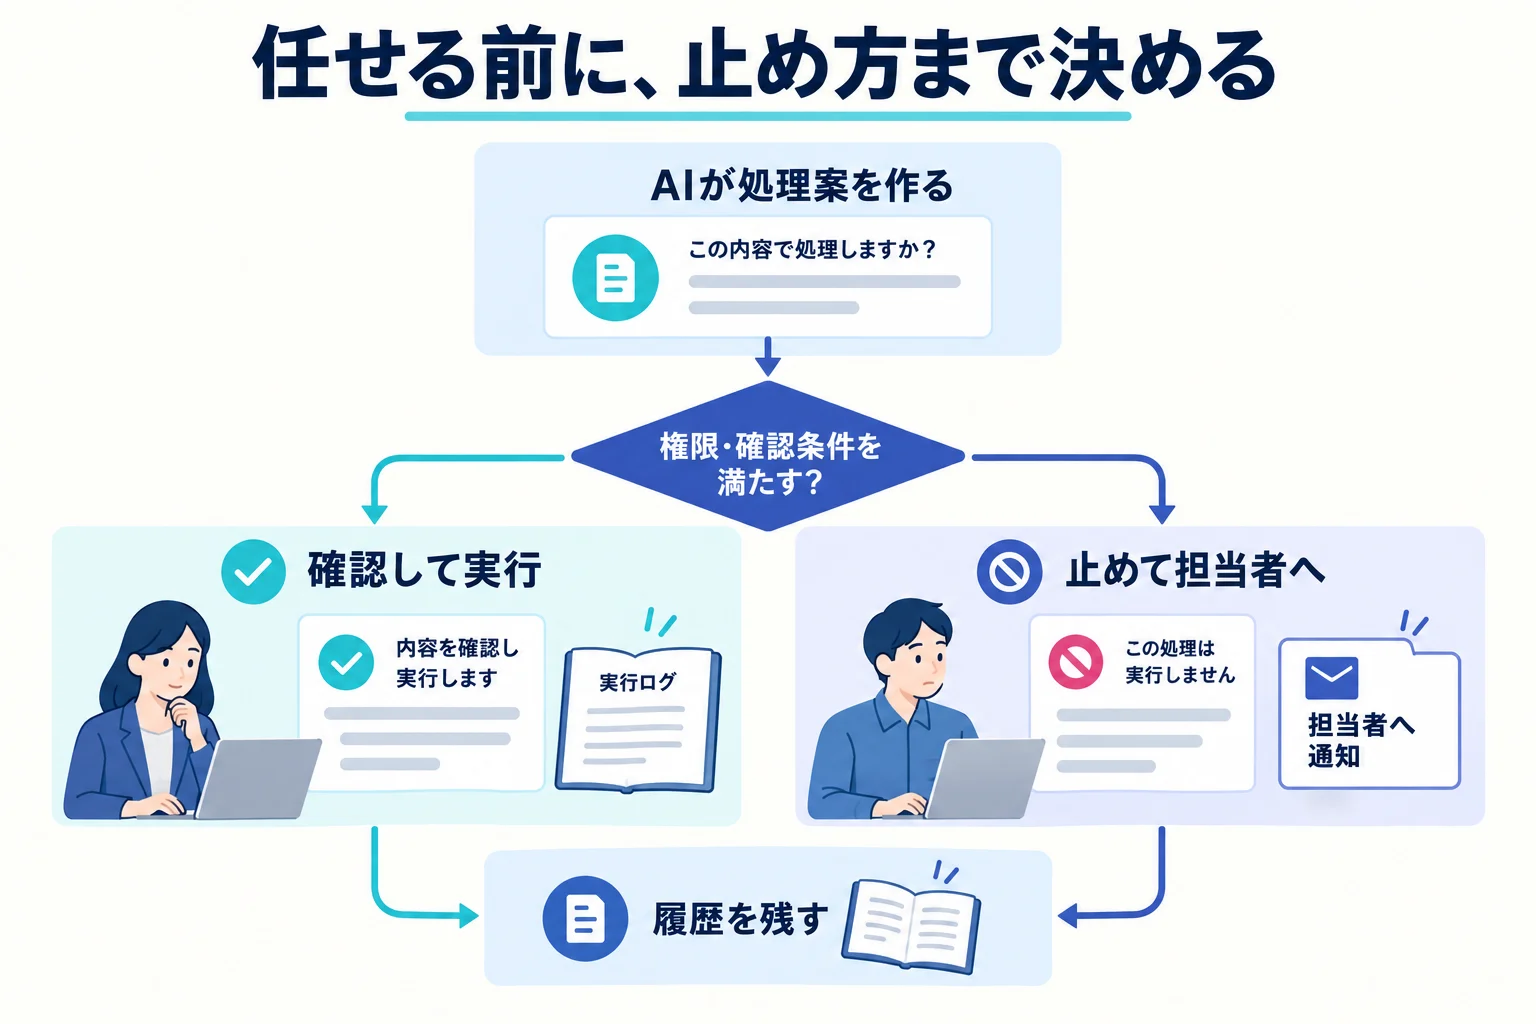
検索AIの精度はモデルだけでは決まりません。文書の鮮度、重複、版管理、権限、質問の種類によって結果が変わるため、導入前に「答えられる範囲」を明確にします。
RISK
どう抑えるか
正本・版・更新日を整理し、回答根拠を必ず表示して人が原本へ戻れるようにします。
GO / NO-GO
AI以前に文書管理を直す必要がある場合は、その範囲を先に切り出します。
RISK
どう抑えるか
実際の利用者から質問を集め、頻出・重要・難問を分けて評価します。
GO / NO-GO
重要質問群で業務利用できる水準に達するかを確認します。
RISK
どう抑えるか
ユーザー・部署・文書単位の権限を検索経路へ反映し、閲覧ログを残します。
GO / NO-GO
既存の権限体系をAI側でも再現できるかを本番前に確認します。
RISK
どう抑えるか
追加・更新・削除の運用担当と同期方法を決め、古い情報が残らない仕組みにします。
GO / NO-GO
継続更新できる運用責任者と手順が決まっているかを確認します。
STOP RULE
AIは実データを当てるまで精度・速度・費用を完全には読めません。最初に成功基準と中止基準を合意し、実データで評価します。基準を満たさない場合は、無理に本開発へ進めず、原因・検証結果・代替案を成果物として残します。見送りを早く判断できることも、検証の成果です。
どのような課題を、どう実装に落としたか
課題
実際のデータ量では、文書単位のベクトル類似度だけでは必要な情報にたどり着けませんでした。回答の根拠を示せないと、業務の判断には使えません。
解決策
メタデータ・全文・ベクトル・グラフ近傍・根拠(Claim)の5経路をRRFで統合し、回答後に根拠を検証する構成にしました。ナレッジグラフはNeo4jで構築し、回答には必ず引用元の本文を提示します。資料に無いことは「資料上は確認できません」と返します。
成果
Beekleだからできたこと
検索方式を先に決めず、精度が出ない理由から設計します。デモで終わらせず、実データを投入して運用を継続しているため、入れたあとに何が起きるかを織り込めます。
課題
品質管理マニュアルや安全規程、作業手順書が500件以上ファイルサーバーに分散し、現場からの問い合わせ対応が品質管理部門に集中していました。
解決策
ファイルサーバーの文書をそのまま取り込み、ブラウザから自然文で質問でき、回答に文書名とページ番号が付くシステムを構築しました。
成果
Beekleだからできたこと
文書を入れる前に、どんな質問にどの根拠で答えるかを決めてから作ります。現場の聞き方に合わせて設計するので、入れたのに使われない状態を避けられます。
課題
法令対応の規程やガイドライン、過去の監査指摘がConfluenceとファイルサーバーに分かれ、監査対応のたびに根拠文書を探し回っていました。
解決策
両方の保管先から文書を取り込み、規程の条項番号まで指定して引用できる検索システムを構築しました。
成果
Beekleだからできたこと
条項単位で引用できるかどうかは、取り込む前の文書の分割設計で決まります。監査に耐える粒度を先に決めるので、あとから作り直す手戻りがありません。
PoCで終わらせず、業務で使える状態まで設計します
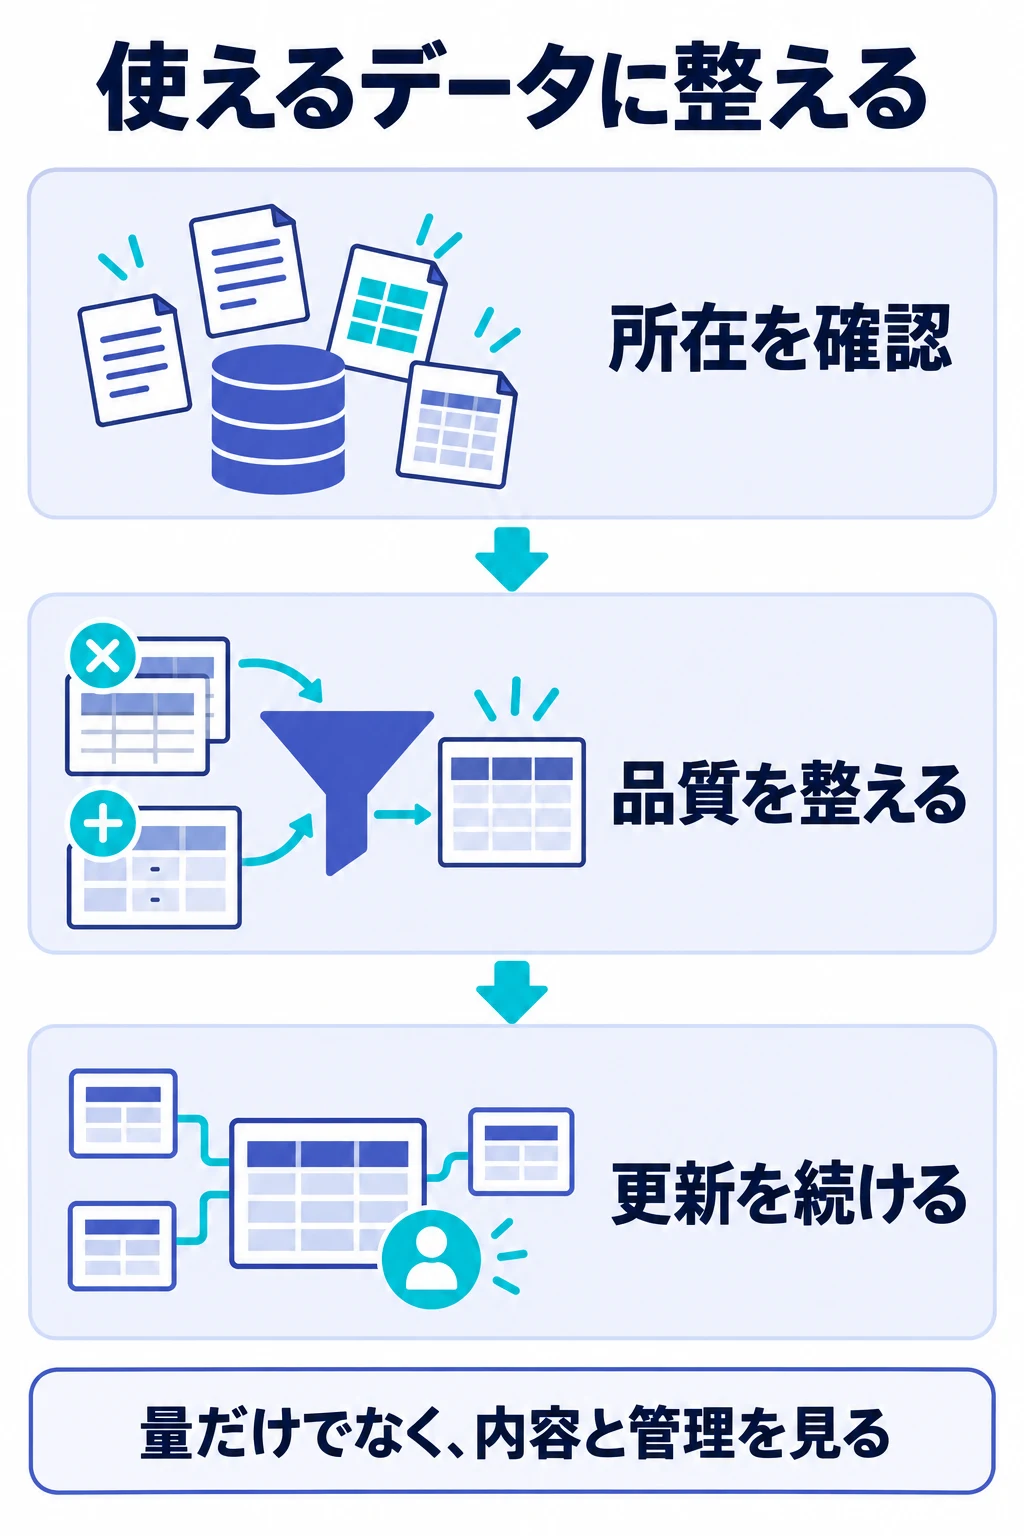
PDF・Word・PowerPoint・Confluenceページなど多様な形式の社内文書を取り込み、御社の業務に合わせたデータベース設計でベクトル化・インデックス化します。パッケージ型ツールが汎用スキーマで処理するのに対し、文書種別ごとのチャンキング最適化と業務固有のメタデータ設計により、検索精度を根本から高めます。自然文での質問に対して、該当文書の該当箇所を引用しながら回答を生成します。
回答には必ず参照元の文書名・セクション・ページ番号を併記します。検索対象に該当文書がない場合は「該当する文書が見つかりません」と回答し、推測で答えない設計を徹底します。
まず特定部署や特定ジャンルの文書からスモールスタートし、効果を確認しながら対象を拡大します。いきなり全社導入せず、小さく始めて実用性を検証してから広げるアプローチです。
技術選定から運用まで、必要な範囲をまとめて引き受けます
いま社内にあるファイルをそのまま渡せます。PDF、Word、PowerPoint、Excel、Confluence、HTMLに対応し、スキャンしたPDFもOCR連携で取り込めます。
検索用のキーワードを考えずに、普段の言葉で聞けます。回答には必ず出典文書名と該当箇所が付くので、そのまま使ってよいかを利用者が判断できます。
自社の文書体系に合わせて分割方法とメタデータを設計するので、パッケージ型の汎用スキーマでは届かない精度が出ます。
精度が上がったのか下がったのかを数値で言えるようになります。改善のたびに勘で判断する状態から抜けられます。
キーワード一致ではなく、質問の意味と文書構造から探す
具体例
社内規程やマニュアルは、言い回しが部署ごとに違い、答えが複数ページに分かれがちです。キーワード検索では大量の候補が出ても、結局人が読み比べる必要があります。
ファイル名や表現が揃っておらず、探す人の経験に依存します。
キーワードを含む資料は出ますが、どこが答えかまでは判断できません。
質問の意味を見て該当箇所を探し、根拠つきで回答します。
一般的な作り方
関連しそうな資料が大量に出て、利用者が自分で読む。
Beekleの作り方
質問への回答と根拠箇所が出るため、確認時間を短縮できる。
Beekleが強い理由
文書の種類ごとに分割方法やメタデータを設計し、回答には根拠箇所を添えます。単なる検索窓ではなく、社内文書を業務で使える回答基盤に変えます。
文書構造に合わせて設計
根拠箇所を提示
部署・文書種別で絞れる
0円で作る範囲と、PoC以降の費用、全体の予算の目安をモデルケースで説明します
期間と体制は、対象業務と連携先、データの状態で動きます。どの案件も、0円の叩き台の後に準委任(月額)で進めます。
POINT 02
実績(事実): カスタマーサポート向けのナレッジ検索の案件では、問い合わせ履歴とマニュアルを対象に、メタデータ・全文・ベクトル・グラフ近傍・根拠(Claim)の5経路を統合して引用元つきで回答する仕組みをデモ開発(PoC)から作り、その後に実データを投入して自社のVPS上で運用を続けています。資料に無いことは「資料上は確認できません」と返す設計です。開発期間と金額は、この案件については公開していません。
POINT 03
0円の叩き台で作る範囲: 1部署の実文書 数十〜数百件を投入し、ハイブリッド検索、根拠の文書名を添える回答、資料に無いことは答えない判定まで動かします。実際の業務質問10〜20問で当て感を確認します。ゼロスタートでは、開発を進める価値を双方で判断できるよう、必要な画面と業務ロジックが動く無料デモを作ります。AI DXはまず1業務に絞り、入力・保存・条件分岐・結果の確認など、その業務を試すための処理も実装します。使用するデータと実装範囲は事前に合意します。本番利用に向けた品質・精度の検証、連携や機能の拡張、運用の整備は、デモで分かった課題をもとに範囲と費用を見積もり、準委任(月額)で進めます。
POINT 04
モデルケース: 対象は1部署の社内規程・マニュアル・手順書(PDF・Word、数百件規模)。作る範囲は、文書の取り込みと分割設計、部署別の閲覧権限、根拠の文書名とページを添える回答、実際の業務質問数十件で作った評価セット、文書更新の反映手順、SlackまたはTeamsからの利用。期間3〜4週間。0円の叩き台の後、準委任(月額)で進めます。
POINT 05
PoCの体制と費用の目安: AIエンジニア1名+エンジニア1名 × 1か月〜、約208万円〜(税別)。叩き台で見えた不確実性だけを範囲にするので、期間と体制はここから増減します。
POINT 06
全体の予算の目安(PoCから本番展開まで): 多くの案件はAIエンジニア1名+エンジニア1名 × 3〜4か月なら、約624万〜832万円(税別)。判断の軸として置いている数字で、同じ体制で続けた場合の合計です。対象範囲と連携先が増えれば期間が延び、金額もこの掛け算で増えます。
POINT 07
本番展開の目安: 複数部署への展開、認証基盤と連携した細かい権限、文書管理システムとの連携、閲覧ログ、更新の運用まで含めて3〜5か月。同じ体制の準委任で続けます。
POINT 08
別料金になるもの: 御社クラウドやオンプレへの構築費とクラウド利用料、LLMのAPI利用料(月額の従量)、紙資料の電子化やOCR、正本が決まっていない文書の整理作業、APIの無い既存システムとの連携開発、Slack・Teams以外のチャネル対応、導入後の保守と精度改善(月額)。
POINT 09
上記のモデルケースは、Beekleの過去の開発案件をもとに条件を組み替えたものです。進め方はどの案件も同じで、NDA締結後に実データを確認し、0円で叩き台を作ってから、双方で進めるかを判断します。合わなければそこで終了し、費用は発生しません。実現の見込みがあれば、叩き台で分かったデータの状態と難しさをもとに範囲と体制を再見積もりし、準委任(月額、税別。単価は職種別に公開)でPoC・本番展開へ進みます。金額の目安は、公開している職種別単価の下限に体制と最短期間を掛けたものです。期間は、対象業務、利用するデータ、既存システムとの連携、精度要件、権限・セキュリティ要件によって変わります。
01
1部署の規程・マニュアル・手順書。PDF・Word、数百件規模。紙は別途電子化。
02
取り込み・分割設計、部署別権限、根拠つき回答、評価セット、更新手順、チャットからの利用。
03
0円デモの後、検証3〜4週間・本番展開3〜5か月。いずれも準委任(月額)。PoCの目安はAIエンジニア1名+エンジニア1名 × 1か月〜、約208万円〜(税別)。全体はAIエンジニア1名+エンジニア1名 × 3〜4か月なら、約624万〜832万円(税別)。
04
インフラ費、API利用料、電子化、文書整理、API無し連携、追加チャネル、保守。
開発をご検討の方に、対象を絞った無料デモをご提案します。PoC(実現性や精度の検証)以降は、担当者の単価・人数・期間をもとに費用を見積もり、契約後に進めます。
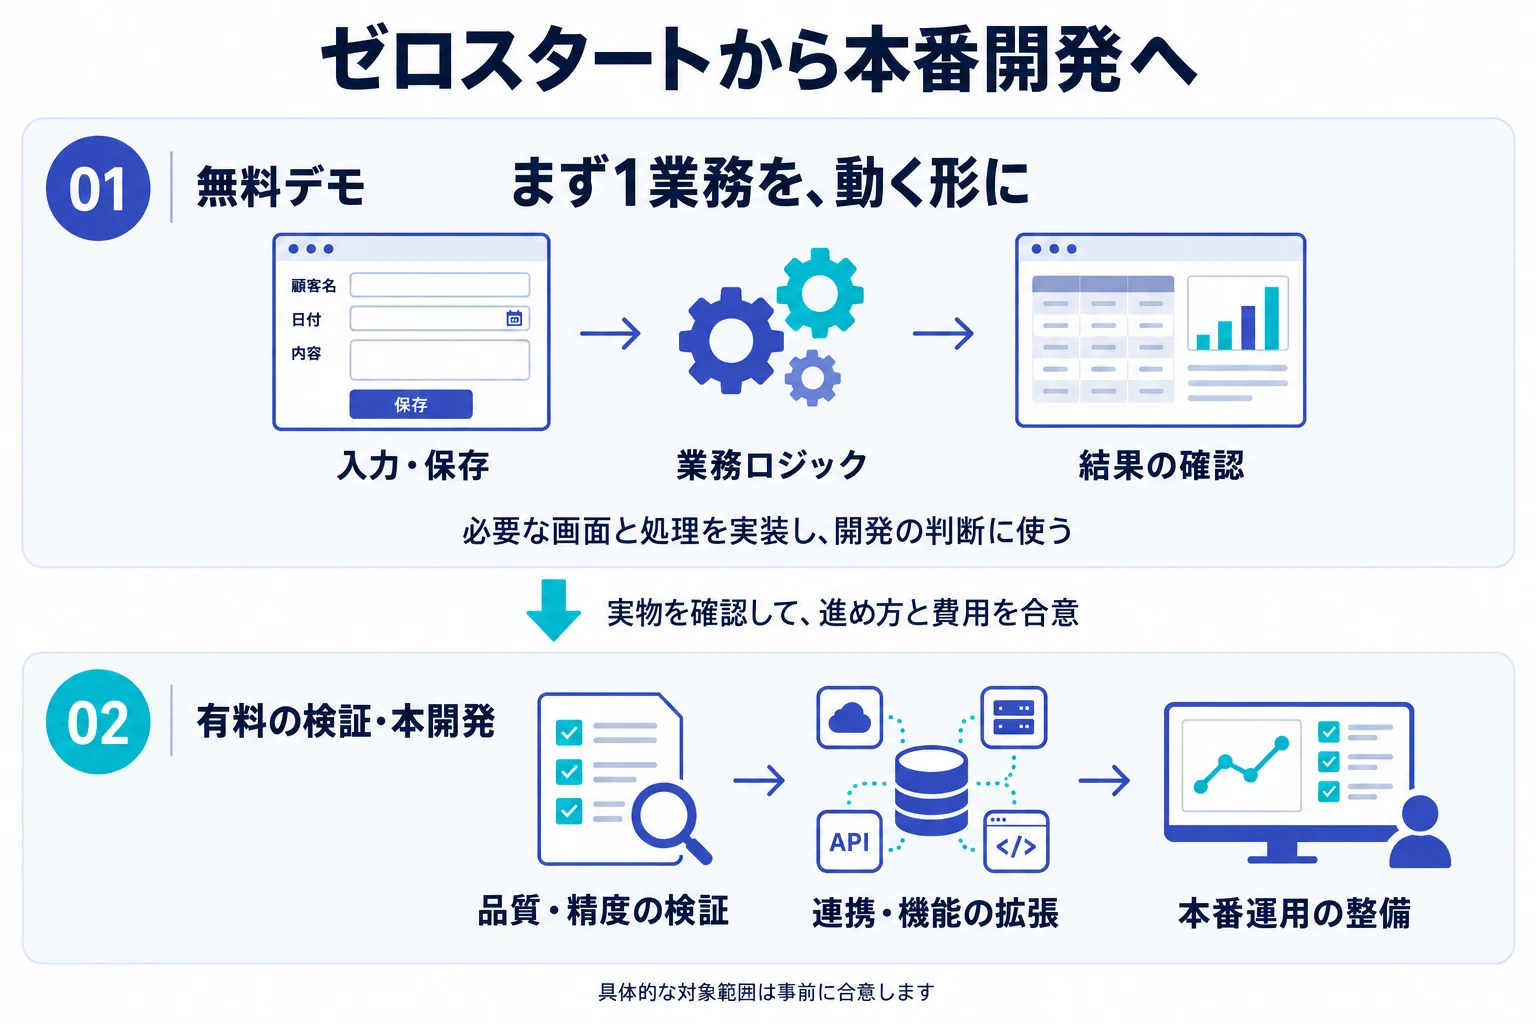
ゼロスタートでは、開発を進める価値を双方で判断できるよう、必要な画面と業務ロジックが動く無料デモを作ります。AI DXはまず1業務に絞り、入力・保存・条件分岐・結果の確認など、その業務を試すための処理も実装します。使用するデータと実装範囲は事前に合意します。本番利用に向けた品質・精度の検証、連携や機能の拡張、運用の整備は、デモで分かった課題をもとに範囲と費用を見積もり、準委任(月額)で進めます。
データの状態と実現性を確認し、無料デモの対象範囲を事前に合意します。経営課題や導入方針を整理する有料コンサルティングとは別のサービスです。
職種別の単価と料金の考え方を見る発注の流れ
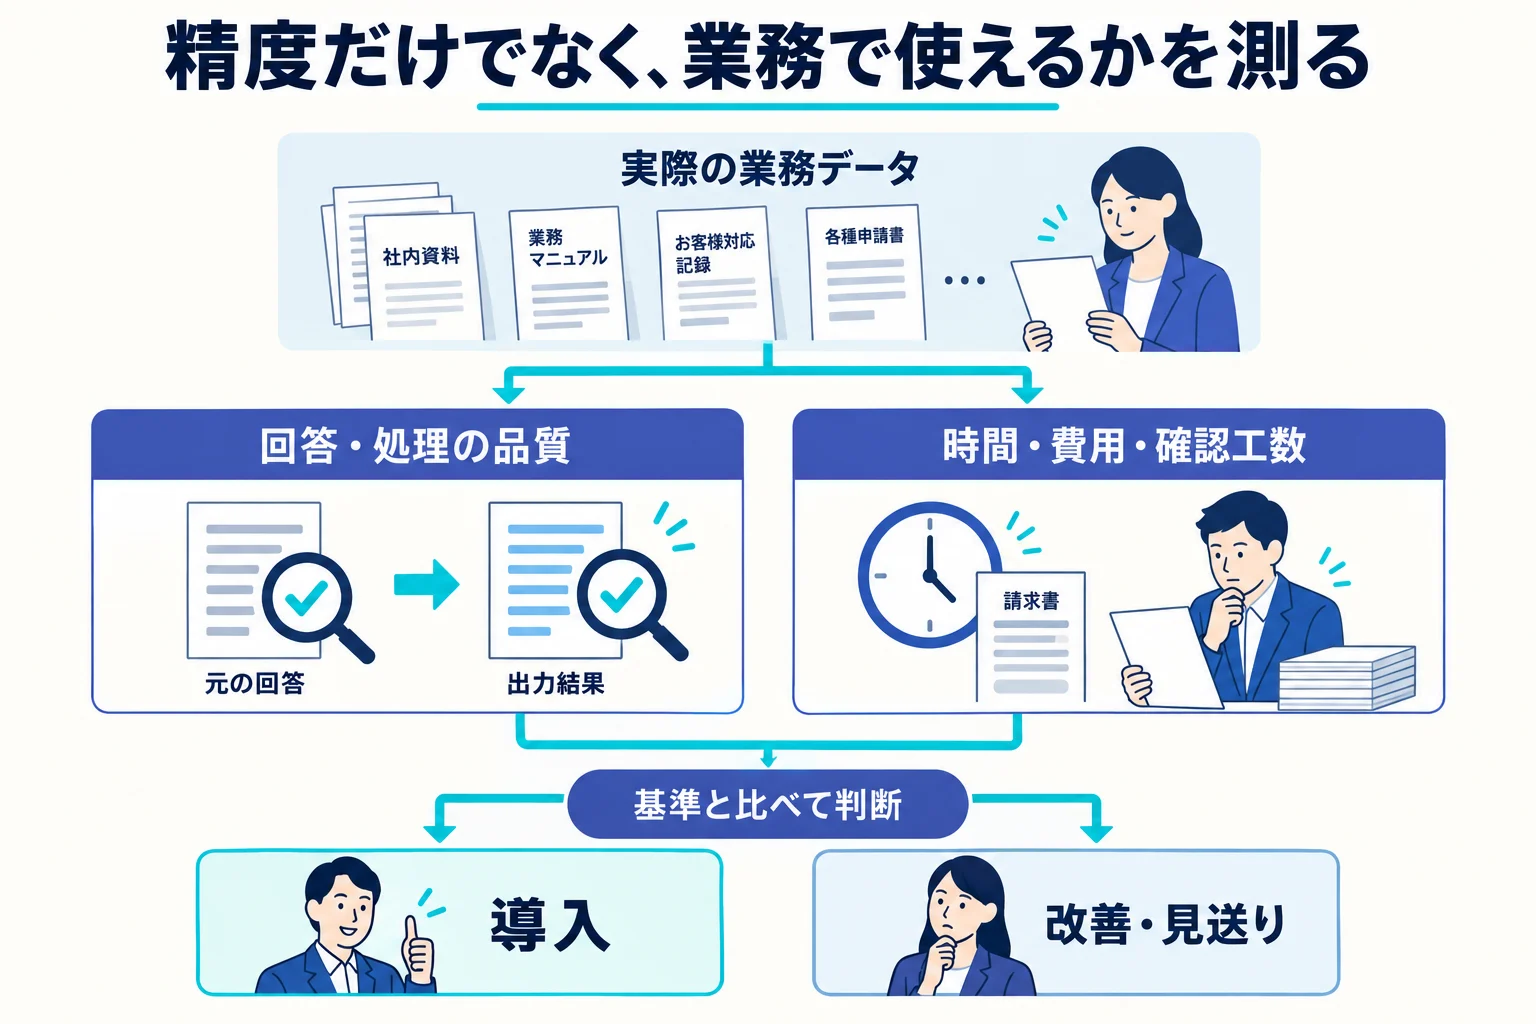
AI開発は、作る前にどれだけ業務を理解し、ユースケースと評価基準を固められるかで決まります。Beekleはヒアリングから入り、設計した範囲だけを小さく検証して本番化します。
STEP 1
現場の作業、判断基準、例外処理、使っているデータを聞き出します。「AIで何か」ではなく、どの業務をどう変えるかまで絞り込みます。
STEP 2
RAGなら文書同士の関係や根拠提示、エージェントなら任せる範囲・承認・ログを設計します。評価データと合格基準も先に決めます。
STEP 3
いきなり大きく作らず、決めたユースケースだけを動く形にします。現場で使えるか、削減時間・精度・確認工数・運用負荷を見ながら検証します。
STEP 4
PoCで効果が確認できたら本番化し、現場で使われる状態まで伴走します。期待した効果が見込めなければ、ここで撤退も判断できます。PoC止まりや過剰投資を避けられるのが、この進め方の狙いです。
技術検証で終わらせず、業務で使える設計に落とす。ここがBeekleの強みです。
このサービスの背景にあるデータ活用の考え方
社内文書RAGで成果が出る案件と、PoC止まりになる案件の分かれ目。
記事を読む →発注先候補をどう絞り、何を比較すれば外さないか。検討段階で押さえる判断軸。
記事を読む →PoC止まりになる典型パターンと、本番化に進めるための評価設計の考え方。
記事を読む →PoC・本番化・運用フェーズごとの費用内訳と、見積もり比較で見るべきポイント。
記事を読む →RAG単体では答えられない「つなぐ・数える・抜けを探す・根拠を示す」問いと、Beekleの進め方を発注者目線で解説。
記事を読む →発注前に確認されやすい論点をまとめています
PDF(テキストPDF・スキャンPDF)、Word(.docx)、PowerPoint(.pptx)、Excel(.xlsx)、Confluenceページ、Google Docs、HTMLに対応しています。スキャンPDFについてはOCR処理を組み合わせてテキスト抽出します。それ以外の形式についても個別にご相談ください。
Azure OpenAI Service等のエンタープライズ環境を利用すれば、文書データがAIモデルの学習に使われることはありません。オンプレミスやVPC内での閉域構成も要件に応じて検討できます。セキュリティ要件は初回ヒアリングで個別に確認します。
完全にゼロにはできませんが、RAG構成により大幅に低減します。回答は必ず検索でヒットした文書の内容に基づいて生成し、該当箇所を引用として併記します。検索対象に該当文書がない場合は「該当する情報が見つかりません」と回答する設計です。重要な判断には原文書の確認を推奨する旨もUIに明示します。
文書の量・形式・連携先によって大きく変動します。初回ヒアリングで要件を確認した上で、個別にお見積りします。初回相談・簡易デモで方向性を確認し、実データや実業務フローを含むPoCは別途範囲を定義してご提案します。
文書数の増加に対してはベクトルDBのスケーリングとReranking(再順位付け)で対応します。文書量が数万件規模になっても検索速度と精度を維持できる設計です。文書が増えるほど回答できる範囲が広がるため、むしろ精度は向上する傾向にあります。
問い合わせの前に
営業資料だけでは、自社に合うか判断しにくいことがあります。社内の制約や今の状況を知っているAIに聞くと、合う理由と合わない理由が先に見えます。